Connaissance · agents
Second cerveau
Tout ce que je lis, écoute et décide finit dans un même endroit, découpé en idées, relié automatiquement, interrogeable en langage naturel. Plusieurs centaines de pages, tenues par des agents sous contrat.
- État
- en usage quotidien · orchestré par agents
- Stack
- Markdown, wikilinks, graphe de connaissances, agents IA orchestrés par un schéma écrit
- Depuis
- 2026
- Preuves
- 344 pages, 45 ingestions journalisées depuis juillet, lint hebdomadaire
Le problème
Des livres, des articles, des vidéos, des décisions prises en réunion, des notes de cours. Tout lu, tout oublié. Ce qu’on retient d’une lecture, c’est rarement ce qu’on aurait dû en retenir, et jamais ce qui la relie à une autre lecture faite six mois plus tôt. Et chaque nouvelle conversation avec une IA repartait de zéro : les décisions déjà prises se rediscutaient à chaque session.
Ce que j’ai construit
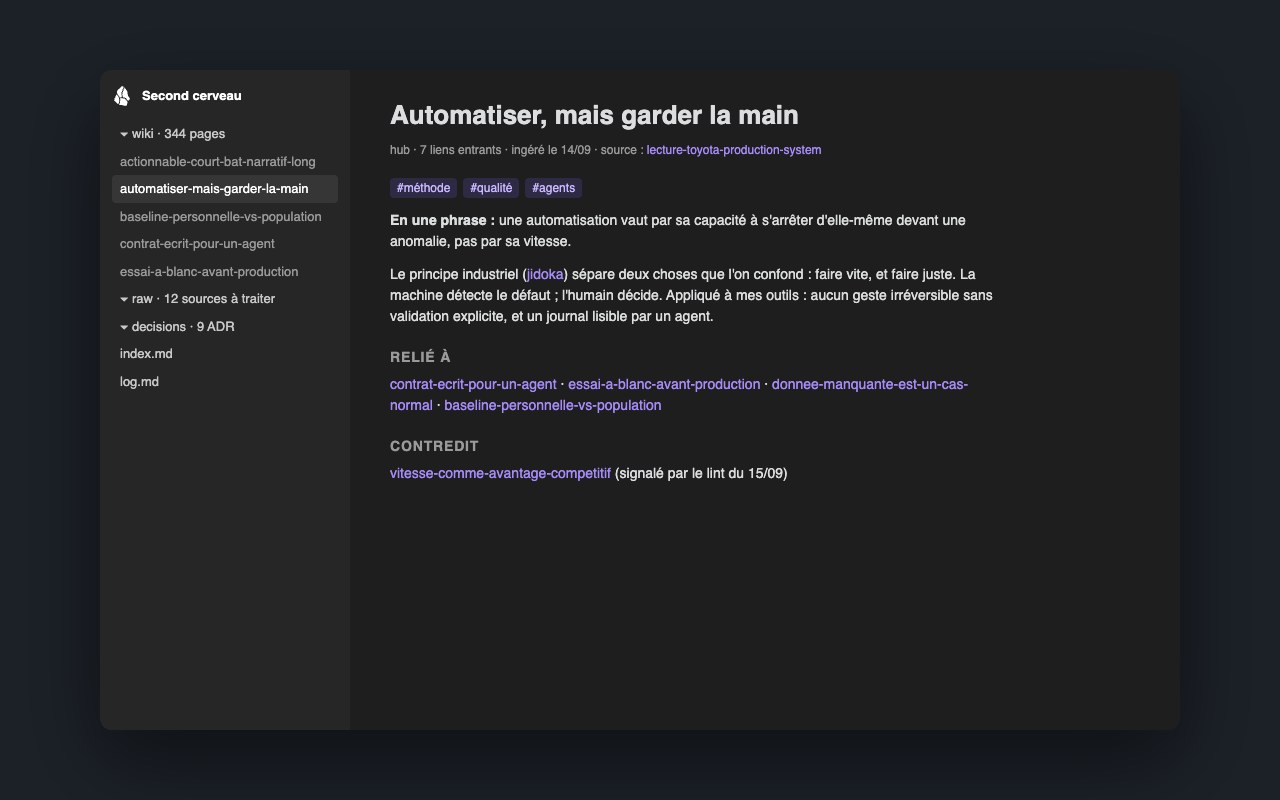
Un vault de texte brut, et un schéma écrit qui dit aux agents comment le faire vivre. Ce n’est pas un pipeline autonome : ce sont des agents qui exécutent un contrat, sous mon regard. Je dépose une source (un PDF, une page, une transcription, des images) et l’agent suit douze étapes dans l’ordre : synchroniser, relire le schéma, lire la source en entier, vérifier qu’une page équivalente n’existe pas, découper en pages atomiques (une idée par page), reformuler avec mes mots, garder une attribution traçable vers la source archivée, poser les liens vers les pages existantes, signaler celles qui deviennent des carrefours, mettre à jour le catalogue et le journal, archiver et vérifier les liens, régénérer le graphe.
Chaque dimanche, une passe de lint cherche les contradictions entre pages, les affirmations dépassées, les pages sans lien entrant, les liens fantômes, les sujets cités mais jamais développés, les sources déposées mais pas encore traitées. Elle rapporte ; elle ne supprime rien seule.
Quand je pose une question, l’agent part du graphe pour cibler les zones utiles, lit les pages réellement pertinentes plutôt que tout charger, répond en citant les pages qui soutiennent chaque point, signale explicitement quand deux pages divergent, et propose d’archiver la réponse si elle vaut d’être gardée. Les décisions importantes ont leur fiche (sept décisions structurées à ce jour) : ce qui est décidé, ce qui reste à valider, ce qui est abandonné.
En chiffres
Environ 340 pages atomiques, issues d’une quarantaine de lots de sources (près de 600 fichiers archivés en comptant les pièces annexes). Environ 1 500 liens explicites vers 500 pages cibles ; environ 270 pages sont des carrefours, reliées à au moins trois autres. Le graphe compte environ 1 850 nœuds, 2 140 arêtes et 385 communautés d’idées. Dernières passes de contrôle : zéro page orpheline, trois divergences documentées comme des différences de périmètre plutôt que des erreurs, trois liens fantômes corrigés.
Ce que ça raconte
- Des agents avec un contrat. Le schéma est un document versionné : les étapes, l’ordre, et les interdits explicites. Jamais inventer une source, une date ou une connexion. Jamais créer une page vide pour réparer un lien. Jamais effacer seul. Jamais transformer une hypothèse en décision.
- La qualité comme routine. Le lint est une campagne de tests sur des connaissances : il distingue une vraie contradiction d’une simple différence de découpage, et laisse la nuance visible.
- Honnête sur ses limites. Le graphe aide à naviguer, il ne prouve pas qu’une relation est vraie. Une information non déposée reste introuvable. Le système le dit plutôt que de faire semblant.
- Un outil qui vieillit bien. Texte brut, liens, un graphe régénéré : rien qui dépende d’un service qui peut fermer. Et le graphe accélère la recherche ; il ne remplace ni la lecture de la source ni l’arbitrage humain.
Ce que j’ai vérifié
- Signal observé : des décisions déjà prises qui se rediscutaient à chaque nouvelle session avec une IA.
- Test ou contrôle : le lint hebdomadaire signale contradictions, pages périmées, pages isolées et sujets manquants ; il n’efface rien.
- Résultat : dernières passes à zéro page orpheline, trois divergences documentées comme des différences de périmètre, trois liens fantômes corrigés.
- Limite actuelle : une source non déposée reste introuvable, et le graphe peut être en retard de quelques jours sur la dernière ingestion.